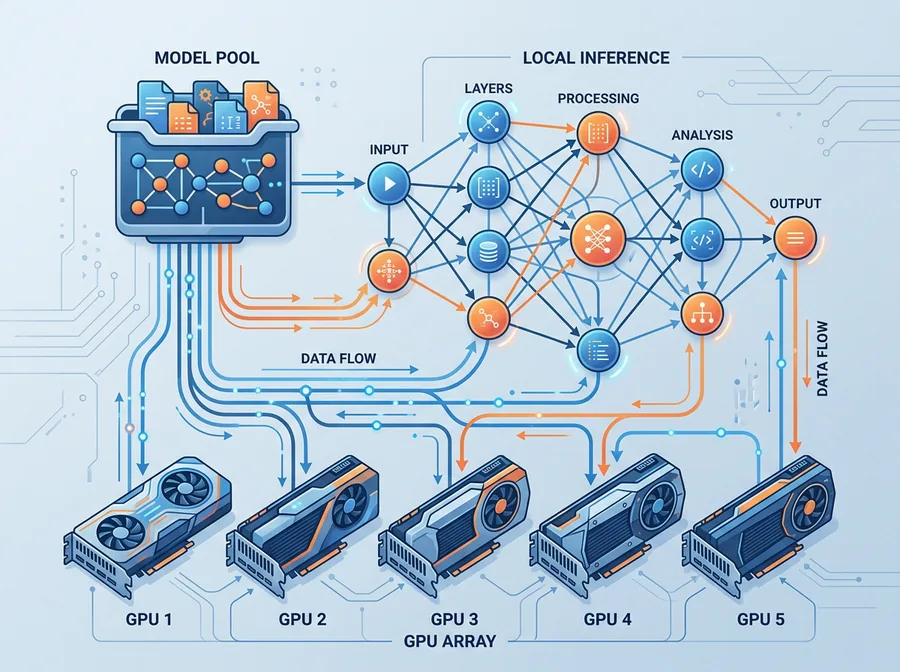
云端白嫖免费额度,本地压榨旧显卡。两条腿走路,哪条断了都不至于停摆。
V100 ×2llama.cppComfyUIOpenAI 兼容网关WoL
云端:把免费额度汇成一个口
各家给的免费额度散在不同平台、不同协议、不同认证方式。中间加一层聚合网关,对外只暴露一个 OpenAI 兼容端点,模型名映射到各家实际后端:
你的程序 / Agent
   ↓  OpenAI 兼容
聚合网关(统一计费、路由、重试)
   ↓
各家免费额度(中文大模型 / 海外模型)
好处是换模型不用改代码,且某家挂了能自动切下一条。
本地:双 Tesla V100
一台旧服务器,两块 V100-16G。跑两套东西——
- llama.cpp:本地大模型,OpenAI 兼容接口
- ComfyUI:SDXL 出图,1024² 热态 8.1 秒,只用单卡 7.2GB
两者靠 systemd 的 Conflicts 分时互斥——显存就那么多,同时跑会互相挤爆。一个切换脚本决定现在给谁用。
绿电思路:不用就关
这台机器常年开着纯属浪费。做了两件事:
- 远程唤醒:发一个魔术包,约 20 秒上线(BIOS WoL 已开)
- 空闲自关:20 分钟没人用就断电,需要时再叫醒
实际体验是「点一下 → 等半分钟 → 开始出图」,比一直开着省电,也不吵。
一个判断
本地推理的价值不在"比云快"——它慢得多。价值在不受限、不花钱、不联网也能跑。适合批量任务和隐私敏感的东西,不适合追求响应速度的对话。